前情提要
硬件
优化的设备是一款智能手表,硬件条件大概是:
- 单核MCU,主频288MHz,带一个2D GPU
- 片内SRAM 256KB,外挂PSRAM
- 屏幕分辨率是 410×480,60Hz刷新率,QSPI接口,扫描线从上往下扫描显示,两次TE间隔大约16.7ms
渲染流水线
优化前,一帧画面的产生有主要的三步:
- UI构建:遍历控件,生成GPU的绘制任务列表
- GPU合成:因为SRAM放不下一整帧,GPU每次只画16行,画在两块小的SRAM行缓冲里,画完一块就DMA搬运到PSRAM的整帧缓存里
- 推屏:整帧缓存完成后,等TE推屏
PSRAM里有两块整帧缓存,一块推屏,一块给GPU写。
问题
之前用低分辨率屏幕,这套渲染流水线大多数时候都能保持60帧,但用上更高分辨率的屏幕后,像素多了64%,帧率掉到了40fps以下。 所以我们的目标很明显,就是优化到能大多数时候稳定60fps。
先搞清楚卡在哪里
我找了一个性能压力较大的界面,分段测试了每一段耗费的时间:
- UI构建:3.5ms
- GPU合成:19ms
- 推屏:19.5ms
帧率 39fps。
改进A:GPU合成和推屏并行
看时间轴(如下图),在原先的流水线里,UI构建、GPU合成、推屏三段是串行的,时间都花在等TE上了。
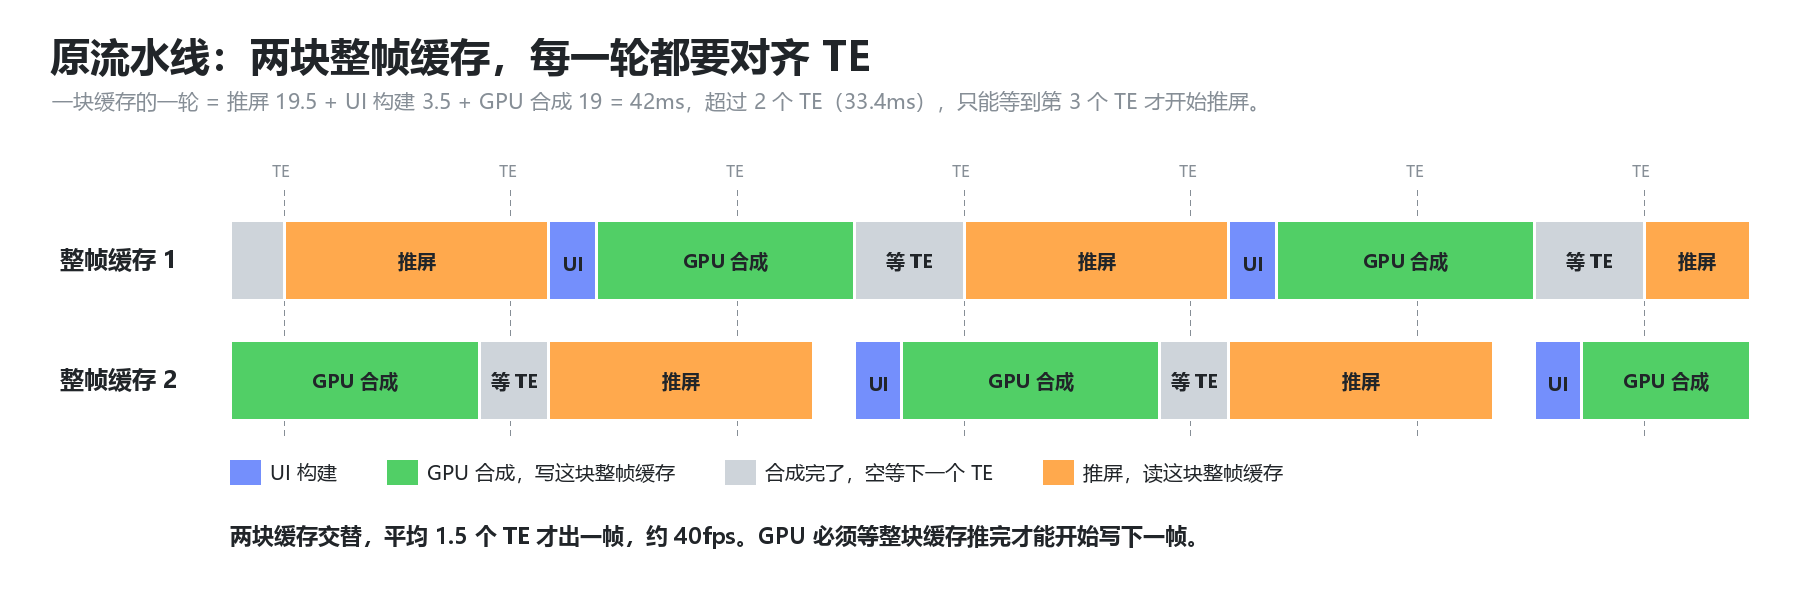
修改前,GPU要等PSRAM的帧缓冲完全推屏完成,才能开始生成。但推屏和生成都是从上往下的,这里就有并行的空间:只要生成进度不要比推屏进度快就行。 完成这个修改后,提升到了44fps。
改进B:UI构建和GPU合成并行
还是延续刚刚的思路,既然合成和推屏可以并行,UI构建和GPU合成也能并行:UI任务链有两条,GPU在进行合成的时候,它正在用的那一条UI任务链不能被改动,但是下一帧的UI任务链是可以提前由CPU生成的。也就是GPU在用第n帧的任务链时,CPU生成第n+1帧的任务链。
完成这个修改后,提升到了46fps。
但有一个点值得关注,就是GPU生成的时间从19ms拉长到了21ms。我怀疑是总线负载限制了速度:GPU读图标贴图、DMA往PSRAM写整帧、推屏从PSRAM读整帧,三者抢的是同一条PSRAM总线;并行之后GPU几乎不停地在跑,和推屏重叠的时间更长。
到这里,我想到了一个事情:如果总线完全给GPU占用,是不是生成时间都能更短呢? 于是我做了一个测试:用同一条UI任务链,多次提交给GPU生成并统计时间,结果GPU生成的时间只要11ms!这是没有UI构建、没有推屏、总线完全空闲时的下界,实际跑起来不可能这么快,但它说明只要把总线腾出来,GPU还有很大的余地。 同时我还测试了增加纯运算的CPU负载,GPU生成时间没有变化;换成读PSRAM的负载,GPU生成时间从约11ms涨到了约16ms。 测试说明,瓶颈是在总线负载上,不在CPU上。
改进C:绕过PSRAM直接推屏
有了改进B中的发现,下一步我们优化的思路就很明确了:降低总线负载。 这里总线是被GPU读贴图、DMA写整帧缓存、推屏读整帧缓存争夺使用的。 很直觉的一个想法是,直接把SRAM缓冲区中的数据搬到屏幕上,而不是搬到PSRAM里再搬运到屏幕显存里,这样能大幅降低总线的压力。同时调高QSPI的时钟,从之前用的48MHz拉高到72MHz。
完成了这个修改后,帧率直接接近60fps(57~59fps),但出现了撕裂。之前48MHz推一帧比屏幕扫一遍还慢,写入一直落在扫描线后面,所以从没撕过;72MHz推得比扫描快,写入会追上并越过扫描线。
处理撕裂
撕裂归根结底就一个原因:显存的写入线和扫描线相交了,因为速率不同。 这里我们采取一个很简单的策略:控制每一块的发出时刻,让GPU生成和推屏等待屏幕的扫描线,每一块都等扫描线扫过它之后才发出,写入线就始终跟在扫描线后面。
需要注意的是,TE后并不是马上就写进屏幕显存的:首块要先发命令、设显示窗口,在我的平台上大约有0.6ms的启动延迟;但后续块是续传,几乎没有这段延迟。所以不能指望这段延迟把写入拖到扫描线后面,时间表本身就要保证每一块都在扫描线之后发出,不依赖任何延迟。
因为SRAM中的块是16行一个块,所以每个块的写入时间是可以计算到的:
| |
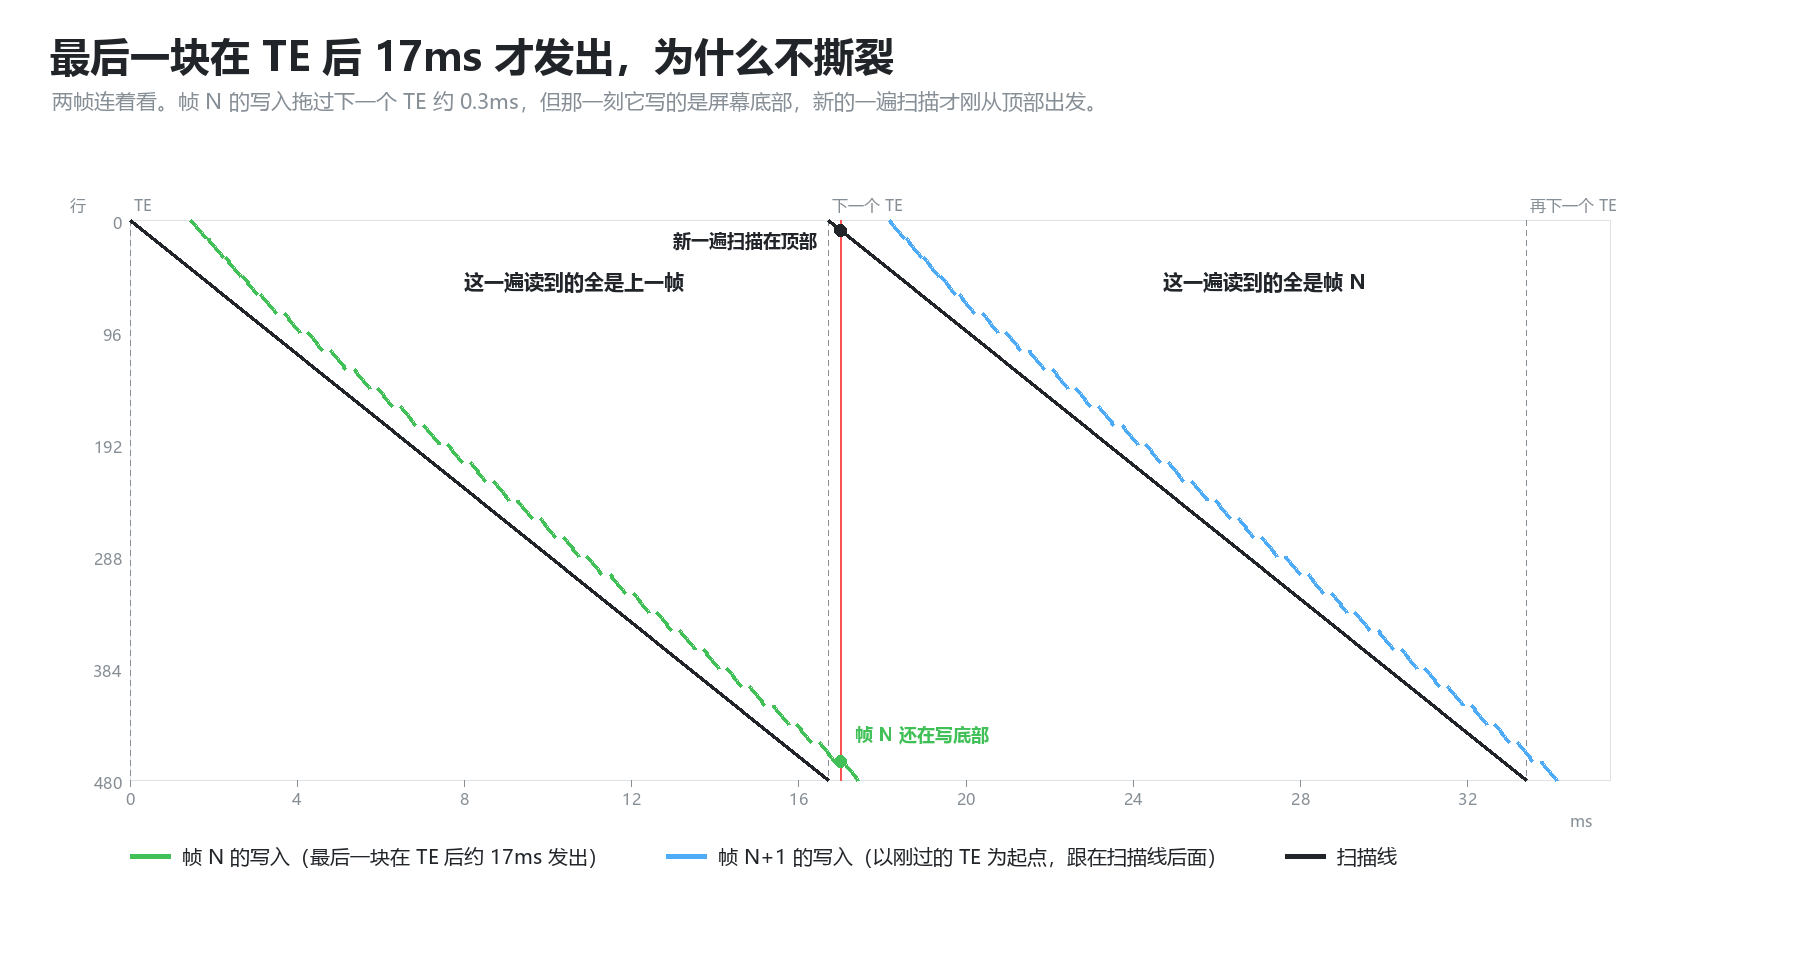
但这样未免太极限了:TE周期是在TE中断里用滑动平均测出来的,有误差,定时等待也有抖动,算出来的时刻稍微早一点,这一块就会写到扫描线前面。所以实际上的时刻是给了0.3ms的余量的:
| |
多了余量后,最后一块的发出时刻会变成TE后的17ms(因为TE周期是16.7ms),但这不会有问题:写入始终跟在扫描线后面(72MHz推屏本身比扫描快,这里的“慢”是我们主动等出来的),最多就是新一遍扫描在扫第一块的时候,我们还在写最后一块。